在化学与材料研究中,贝叶斯优化、进化算法以及其他黑箱优化方法,正被越来越多地应用于自动化实验室与自主科学发现。然而,一个长期存在的问题是:我们如何判断一种优化算法是否适用于真实实验?面对有限的实验预算,选择何种优化算法,直接影响下一次实验能带来多大进展。
现有算法通常在解析测试函数或少量标准数据集上进行比较。这些基准具有可重复、成本低等优点,却往往难以充分反映真实实验中的复杂性,例如连续、离散和类别变量并存,组分比例需要满足约束,部分变量只能按照固定步长调节,不同实验还可能具有不同的物理边界和可行域。在解析测试函数上表现优异的算法,未必能在真实化学实验中保持优势。研究者需要更贴近实验条件的依据,来判断一种方法能否在有限预算内更快找到有价值的候选条件。
近日,中国科学技术大学智能科学家团队在arXiv发表预印本RECOB: Reliable Benchmarking of Experimental Optimization in Chemistry and Materials Science,回应这一问题。该工作构建了RECOB(REliable Chem Optimization Benchmark):一个以真实化学与材料实验数据为基础、经过系统可靠性检验的黑箱优化基准。
在统一评测协议下,RECOB揭示了不同算法在最终性能、优化过程和计算开销上的差异:HEBO在单目标任务中综合排名最佳,qNEHVI在两项多目标任务中总体领先。单目标任务上的独立重训与实测数据回放进一步检验了相应结论的稳定性及适用边界,为实验前的算法筛选提供了可复现的比较依据。
从5291条真实实验记录构建算法评测任务
RECOB的基础数据全部来源于实际完成的物理实验,而非人工生成的解析函数或计算性质数据。算法评测则基于这些数据构建的虚拟实验环境与实测数据回放来开展。
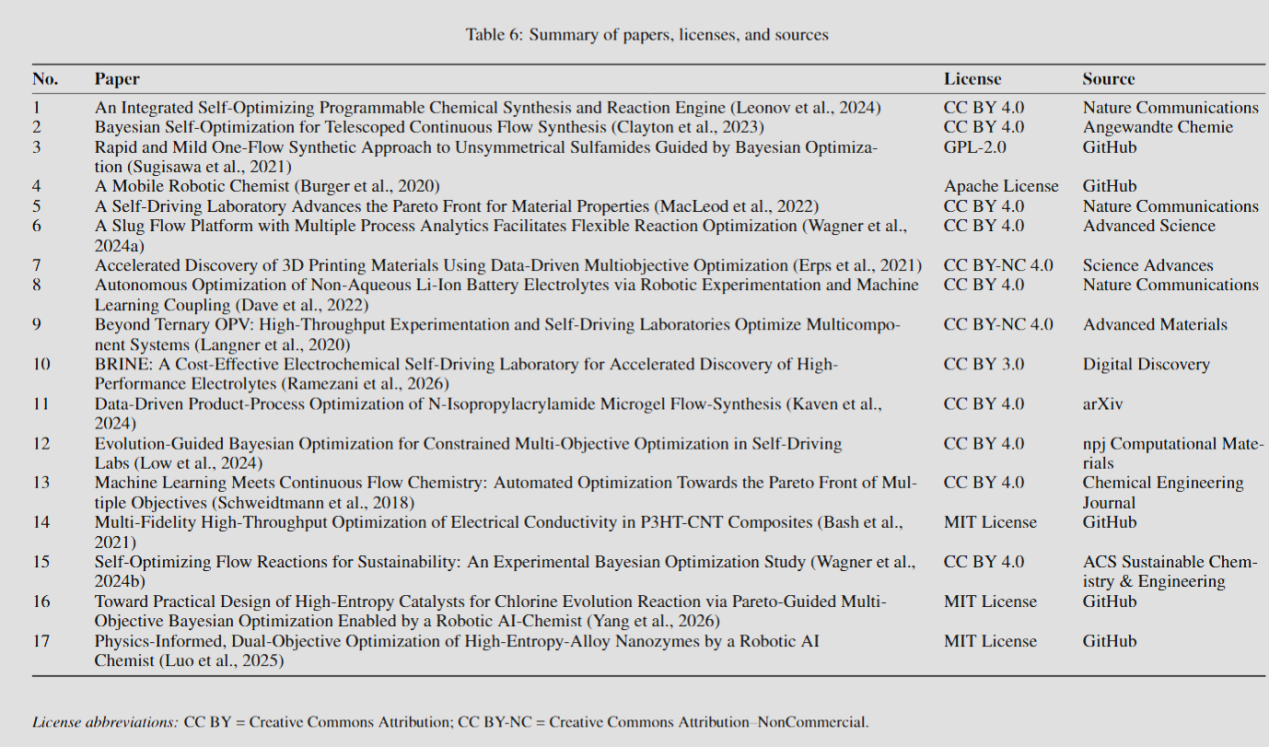
该工作系统整理了来自约17项公开研究的19个实验数据集,共包含5,291条实验记录。这些实验覆盖了多个具有代表性的化学与材料场景,包括:
-化学反应与酰胺偶联优化;
-连续流化学过程;
-锂离子电池电解液设计;
-有机光伏材料配方;
-银纳米颗粒合成;
- P3HT–CNT导电复合材料;
- 3D打印材料设计;
-电化学体系;
-移动机器人化学家与自动化实验室。
通过将每项实验的决策变量、变量类型、物理单位、取值范围、步长、类别选项、联合约束、非线性约束、优化方向及数据来源整理为统一的机器可读任务规范,不同优化算法能够在相同的实验定义和约束条件下进行比较。研究者因此可以复用已有的任务定义与数据处理成果,把更多精力用于算法设计和性能分析。
检验预测精度与评测结论的稳定性
仅靠实验数据,并不足以自动得到一个可靠的优化基准。为了让算法能够提出新的实验条件,我们利用实验数据训练了可反复查询的代理模型(Oracle),预测给定条件下的实验响应。关键在于:模型能否可靠地反映实验数据中的规律,评测能否区分算法优劣,以及算法排名是否会随模型训练的随机变化而改变。为此,RECOB设置了系统的任务准入与可靠性审计流程。
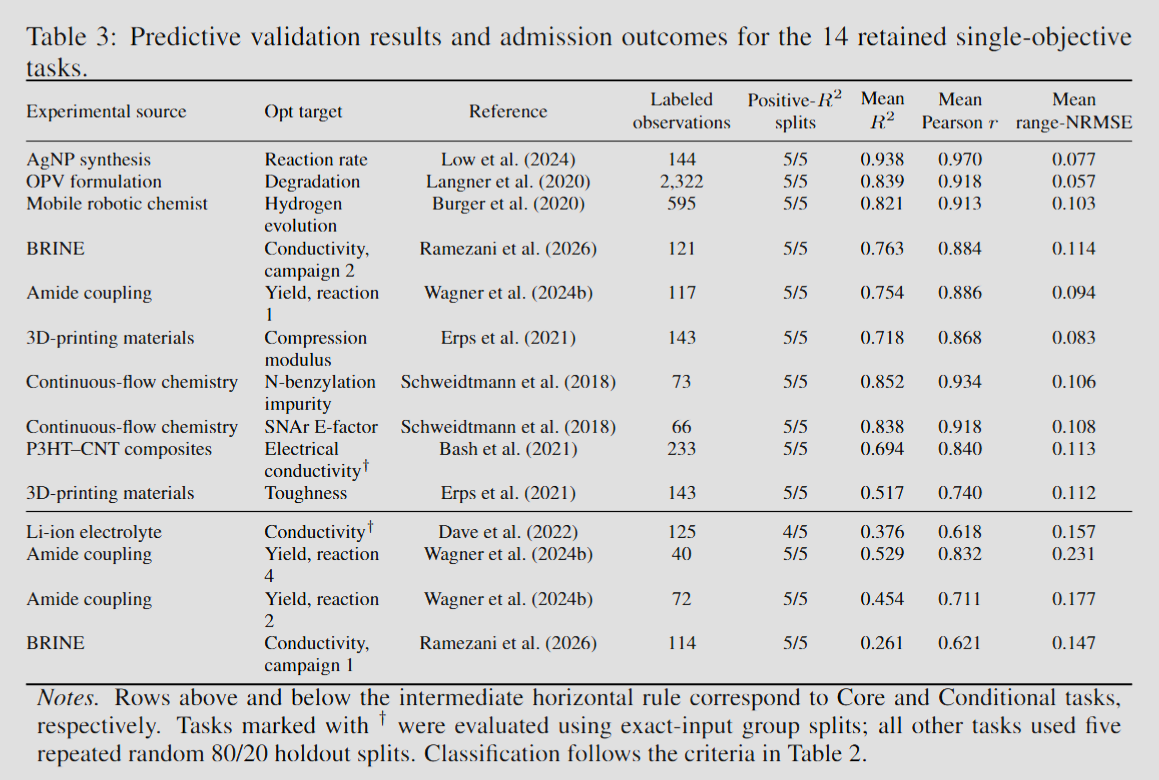
首先,我们使用五组固定的80/20训练—验证划分,从平均预测性能、最差划分表现以及不同划分之间的稳定性等方面筛选任务。对于包含相同实验条件重复测量的数据,我们采用按输入分组的划分方式,避免相同条件同时进入训练集和验证集造成信息泄漏。经过筛选,最终形成14个单目标优化任务和2个多目标优化任务,其中单目标任务进一步标记为10个Core(核心)任务和4个Conditional(条件准入)任务,以明确记录代理模型的可信度层级。
其次,我们设计了两条互补的评测路径。一是连续代理模型评测:算法可以在满足变量类型、步长与物理约束的可行域内提出新条件,由代理模型返回预测响应,适合开展大规模、可重复的优化比较。二是实测数据回放评测:将算法提出的条件匹配到尚未使用的实测条件,并返回对应的实验测量响应。前者允许探索原始数据表之外的条件,后者提供基于已有实测响应的对照。二者结合,可以检验算法结论是否依赖于评测方式。
在统一协议下比较单目标与多目标优化方法
在单目标任务中,我们比较了10种代表性方法,包括随机搜索、Sobol搜索、CMA-ES、Optuna TPE、基于高斯过程或随机森林的贝叶斯优化方法,以及HEBO、Gryffin等面向复杂实验空间的优化框架。在多目标任务中,我们进一步比较了8种方法,包括qNEHVI、qNParEGO、MESMO、JES、TSEMO、NSGA-II以及随机和Sobol基线。
为了确保可比性,在主评测中,每个“任务—试验”组合都采用完全相同的10个初始实验条件。在此基础上,各算法继续进行100次序贯优化,总评估预算为110次。每项任务重复20次,并同时评价:
-最终能够找到多好的实验条件;
-在整个优化过程中提升得有多快;
-不同任务上的总体排名是否稳定;
-生成下一个实验条件需要多少计算时间。
算法选型需要兼顾优化效果与决策开销
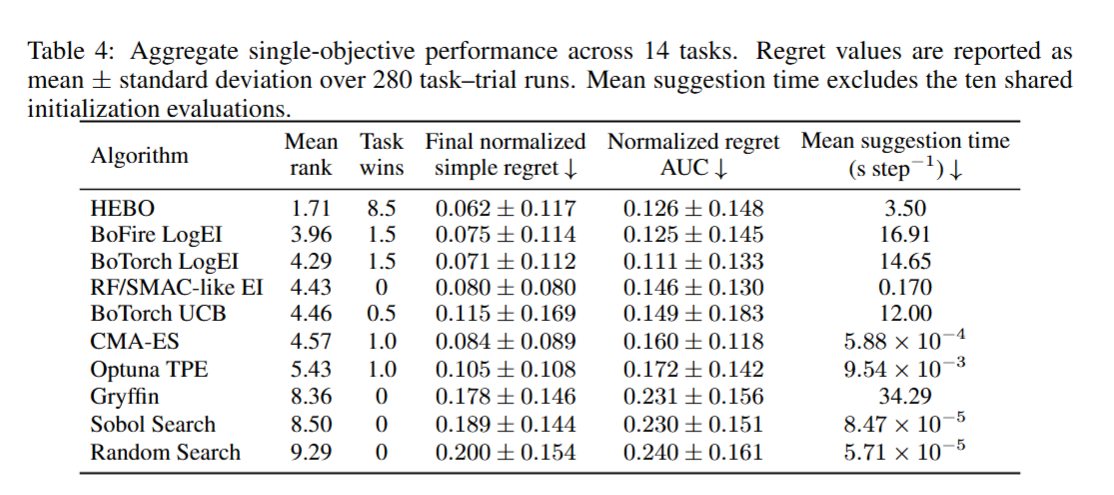
在本研究设定的14个单目标任务和评估预算下,HEBO获得了最佳综合排名:在8个任务上单独取得第一,并在另外2个任务上并列最佳。不过,“最终找到最好结果”和“早期提升最快”并不是完全相同的概念。BoTorch LogEI获得了最优的全过程regret AUC(综合衡量搜索过程中与基准参考最好值的差距,越低越好),体现出较强的过程效率;HEBO则在更长的预算中持续改进,最终取得最佳总体排名。这为不同实验预算下的算法选择提供了参考。
不同方法的计算成本也存在显著差异。在本研究的计算环境与实现设置下,算法生成一次新实验建议所需的平均时间相差超过五个数量级。RF/SMAC-like EI在保持较强优化性能的同时,平均每一步仅需约0.17秒,在性能与计算成本之间取得了较好平衡;CMA-ES和TPE的建议开销更低,而部分复杂贝叶斯优化方法则需要更长的计算时间。这意味着,在真实实验中选择优化算法时,还需要将实验预算、计算资源和决策耗时与实验节奏统筹考虑。
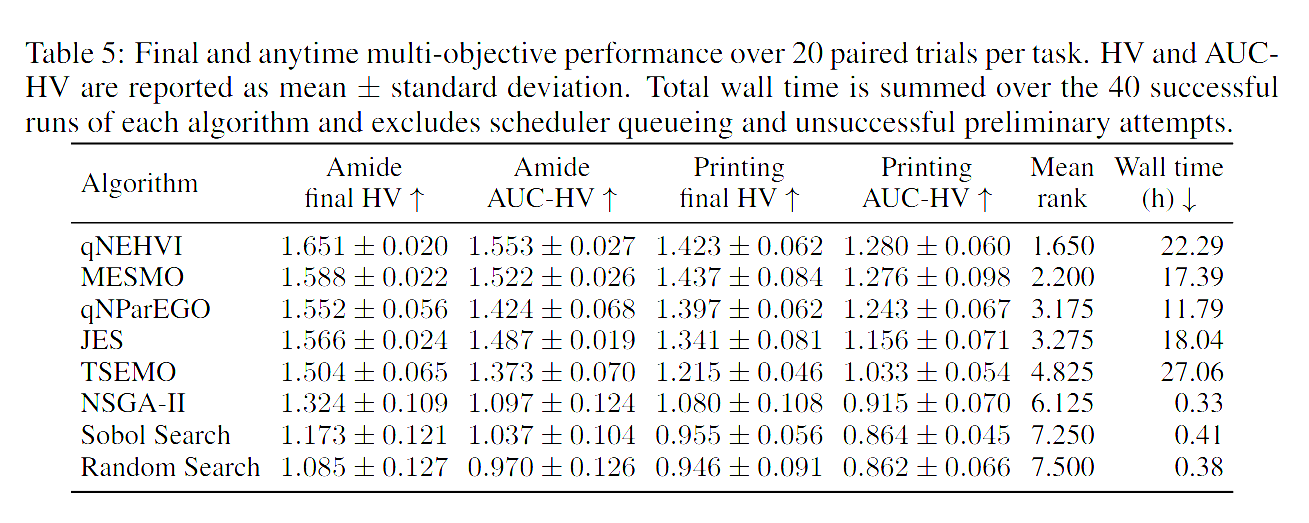
在两个多目标任务上,qNEHVI获得了最佳总体排名,并在两个任务上都取得最高的全过程平均超体积。超体积用于衡量一组候选方案在多个目标之间的综合表现,同一任务中通常越大越好。MESMO则在3D打印材料任务上获得了最高的最终超体积,表明不同多目标优化机制仍然具有任务依赖性。由于目前仅覆盖两个多目标任务,这些结果应作为当前任务范围内的比较依据。
独立重训与实测回放检验排名稳定性
为检验算法排名是否受单次代理模型训练的偶然影响,我们在6项代表性任务上,使用不同随机种子独立训练了三组代理模型,并重新运行10种单目标方法的比较。结果显示,不同代理模型下的总体算法排名高度一致:
- Spearman排名相关系数达到0.964–1.000;
- Kendall排名相关系数达到0.911–1.000;
-独立代理模型之间的预测相关系数达到0.986–0.999。
在这6项任务的总体比较中,HEBO、BoFire LogEI和BoTorch LogEI始终位于领先组;RF/SMAC-like EI、BoTorch UCB、CMA-ES和TPE位于中间组;随机搜索、Sobol搜索和Gryffin则稳定处于较低排名。这说明,在所检验的任务和训练设置下,RECOB的总体结论对代理模型训练中的随机变化具有较强的稳健性。
进一步地,在6项代表性任务、总预算60次的实测回放比较中,较强的模型驱动方法与非自适应基线之间的总体层级仍然得到保留,但领先组与中间组方法的具体排序发生了变化。这一结果也揭示了一个容易被忽略的问题:有限实测候选集上的回放,与允许提出新条件的连续代理模型优化,定义了不同的评测问题。随着候选逐步被消耗,不同算法越来越容易访问到相同或相近的高性能记录,最终差异会被压缩。
因此,RECOB提供的不只是一组算法排名,更是一套可重复、可审计的实验优化评测框架。通过展示结论在不同评测协议下何处一致、何处变化,它帮助研究者理解算法优势的适用条件,为后续实验部署作出更有依据的选择。
为智能科学家的实验决策提供评测基础
自动化实验室和AI for Science正在快速发展,但真实实验通常昂贵、缓慢且难以大规模重复。为了比较几种算法就重新开展数百甚至数千次化学实验,对研究者而言并不现实。RECOB在解析测试函数与真实实验部署之间提供了一套可复用的评测环境:利用公开的实验数据构建可重复查询的优化任务,同时通过严格筛选、独立重训练和实测数据回放,对评测结论本身进行可靠性检验。研究者可以据此先比较候选算法的优化效率与计算代价,再有针对性地开展实验验证。
对于需要自主规划实验的“智能科学家”,根据已有结果决定下一步做什么实验,是一项关键能力。RECOB的统一任务定义、物理约束与反馈接口,为检验这一决策环节提供了可重复的测试环境。
我们希望RECOB能够为化学、材料科学、黑箱优化和自动化实验室研究提供一个更加真实、透明和可复现的公共测试平台,也欢迎研究者使用这一基准评估新的优化算法与实验决策方法,让后续的实验投入有更充分的证据支持。
论文:RECOB: Reliable Benchmarking of Experimental Optimization in Chemistry and Materials Science
arXiv:https://arxiv.org/abs/2609.20891
代码与数据:https://github.com/XieZikai/RECOB